如果一個科技團隊在 2024 年導入生成式 AI,主要的技術工作多半落在檢索增強生成(RAG)架構:架設向量資料庫、切分內部文件區塊、調整檢索相似度閾值,最後把召回的上下文組合進提示詞,交給大型語言模型產出答案。這套模式能回答靜態知識庫的問題,但只要業務需求跨進「檢查庫存後自動向供應商建立採購單」或「分析顧客未付款原因並在 CRM 觸發客製化補償方案」,單純的文字補全架構就會碰壁。
這個斷點讓生成式 AI 的主戰場在 2025 到 2026 年迅速移轉。Microsoft Azure、Amazon Web Services(AWS)與 Google Cloud Platform(GCP)三大公有雲服務商,不再只比拼誰家託管的基礎模型推論延遲更低或價格便宜幾分錢,而是傾全力競逐 AI Agent(人工智慧代理)的基礎設施與開發框架。從微軟整合的 Azure AI Foundry、亞馬遜的 Amazon Bedrock Agents,到 Google Cloud 的 Vertex AI Agent Builder,雲端三巨頭正把軟體工程從「由工程師撰寫確定性代碼調用 API」推向「由模型自主規劃步驟並調用工具完成目標」。
對於架構師、技術主管與工程團隊來說,這不只是換了一批 SDK 或雲端託管服務,而是軟體系統架構與後端工程思維的根本重塑。
為什麼雲端三巨頭把戰場從基礎模型轉向 AI Agent
回顧雲端運算的發展脈絡,基礎模型(Foundation Models)的競爭正在走向商品化與公用事業化。不論是 OpenAI 系列、Anthropic Claude、Google Gemini 還是開源的 Llama 體系,頂尖模型的推理能力差距逐漸縮小,每百萬 Token 的呼叫成本也以每年倍數級別下降。單純靠模型調用的轉售差價,無法為雲端巨頭建立長期的護城河。
雲端巨頭真正看中的,是企業 運算負載(Workload)與系統粘著度。一個成熟的 AI Agent 系統包含規劃引擎、外部工具介面、狀態持久化資料庫、長期記憶體與安全防護網:
| 雲端平台 | 主力 Agent 開發環境 | 核心協作框架與編排工具 | 企業安全與護欄服務 |
|---|---|---|---|
| Microsoft Azure | Azure AI Foundry | Semantic Kernel、AutoGen、Copilot Studio | Azure AI Content Safety、Azure Private Link |
| AWS | Amazon Bedrock Agents | LangGraph on AWS、Bedrock Action Groups | Amazon Bedrock Guardrails、IAM 角色隔離 |
| Google Cloud | Vertex AI Agent Builder | Vertex AI Reasoning Engine、LangChain on Vertex | Model Armor、VPC Service Controls |
當企業開始在雲端平台上構建具有自主規劃與執行能力的 Agent,其背後消耗的運算資源不再只是單次的語言模型推論,而是包含關聯式資料庫讀寫、向量檢索、無伺服器計算(Serverless Computing)、訊息佇列、網路傳輸與合規日誌審計。雲端巨頭將戰場推進到 AI Agent,本質上是在搶奪未來十年企業關鍵業務軟體的執行引擎。
架構轉變一:從靜態 RAG 檢索,走向多步推理與自主規劃循環
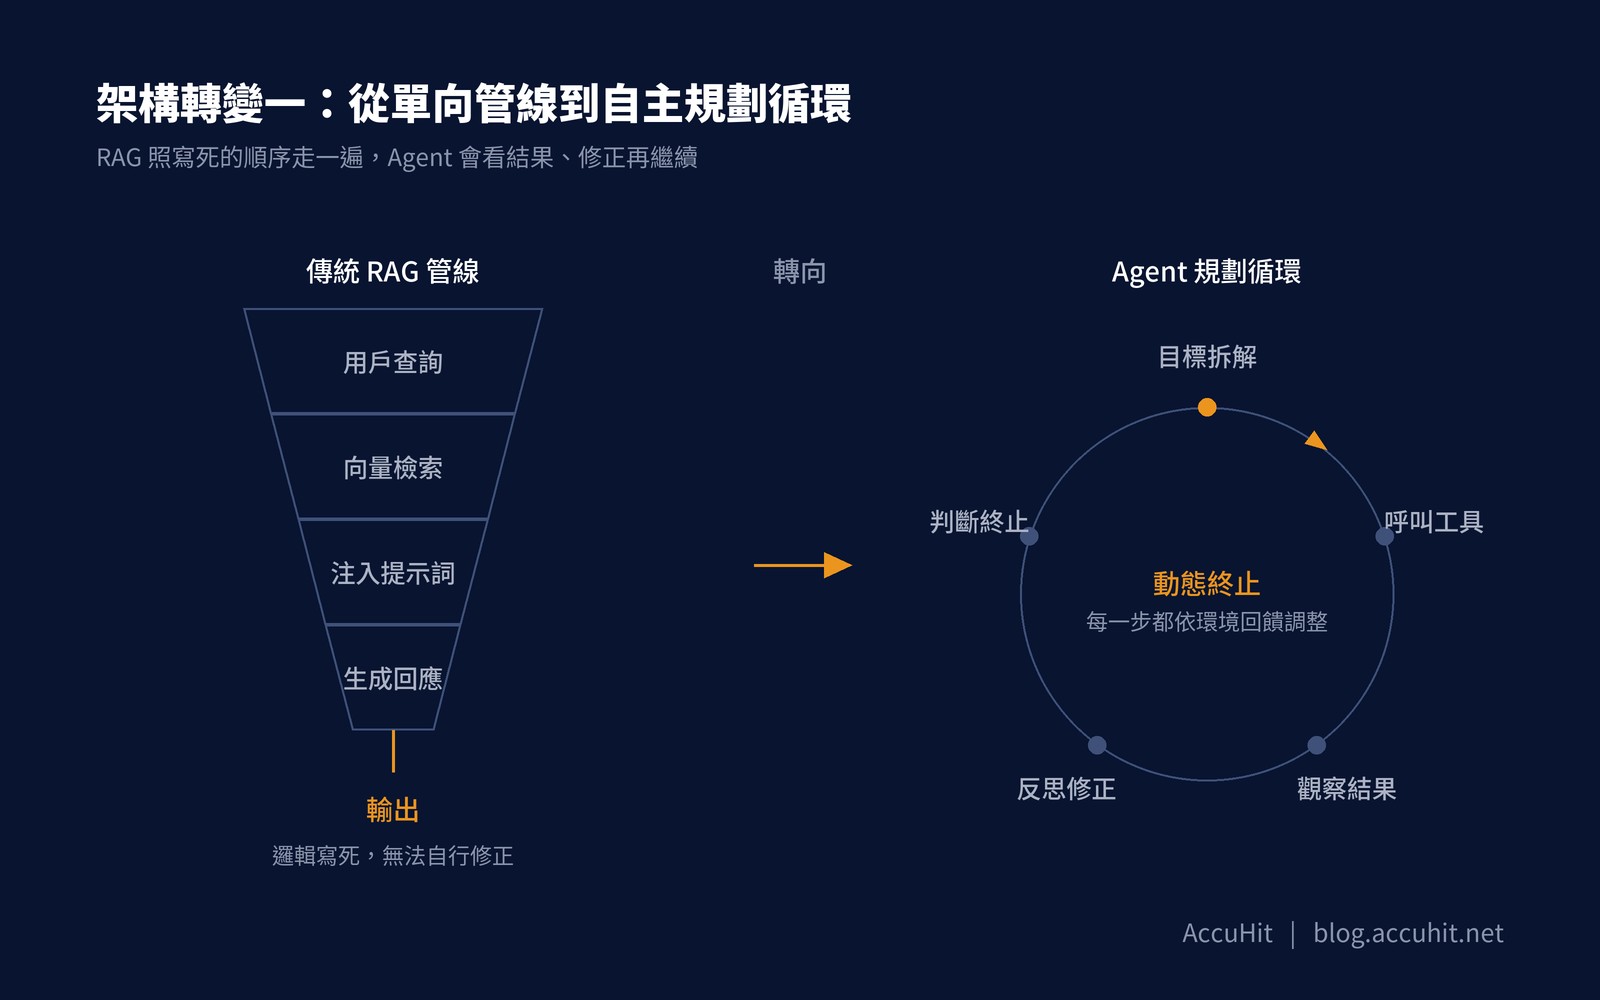
傳統 RAG 的架構本質上是單向管線(Linear Pipeline):用戶輸入查詢,系統經由 Embedding 模型向量化後在向量資料庫檢索相似文本,再將文本注入 Prompt 模板交由 LLM 生成回應。這種靜態管線完全依賴工程師在程式碼中寫死的邏輯,一旦檢索出的內容資訊不足、存在矛盾,或者需要跨越兩個以上的系統逐步求解,系統就無法自行修正。
自主規劃循環 徹底顛覆了這種線性模式。在以 ReAct(Reasoning + Acting)或 Plan-and-Solve 為代表的 Agent 架構中,模型被賦予了動態評估環境與調整路徑的能力:
- 目標解析(Goal Decomposition):Agent 接收到複雜指令時,會先將目標拆解為可執行的子任務清單。例如面對「分析本季流失率異常的經銷通路並提出修復方案」,它會先呼叫數據倉儲拉取報表,而非直接通篇猜測。
- 觀察與反思(Thought & Observation):每一次執行外部動作後,Agent 會讀取回傳的環境狀態(Environment State),比對目前進度與最終目標的差距。如果 API 回報連線超時或查詢結果為空,它能自主切換查詢參數或改採備用路徑。
- 動態終止條件(Dynamic Termination):不同於傳統程序碼依賴寫死的條件分支,Agent 能夠在多步推理過程中評估是否已獲得足以回答問題或完成任務的證據,自行決定結束循環或繼續深究。
在 AWS Bedrock 中,這項機制被抽象為 Action Groups 與自動化 Prompt 模板;在 Google Cloud Vertex AI 中,Reasoning Engine(推理引擎)允許工程師使用 Python 原生類別封裝業務邏輯,並由 Gemini 1.5/2.0 模型驅動規劃循環;微軟的 Semantic Kernel 與 AutoGen 則提供高度靈活的 Planner 介面,讓技術團隊能夠精細控制 Agent 在推理過程中的遞迴深度與 Token 消耗上限。
架構轉變二:從封閉文本輸出,走向受控的工具執行與系統整合
語言模型早期的應用侷限在文字輸入與文字輸出,即使生成了具備高價值的分析建議,依然需要人工複製貼上到 ERP 或 CRM 系統才能產生業務價值。在現代雲端架構中,模型必須成為能夠驅動真實世界系統的「大腦控制器」。
要讓模型安全、可靠地調用外部系統,雲端平台普遍採用了基於 OpenAPI 規範(Swagger)的函數調用(Function Calling)機制。技術團隊只需向平台註冊 API 的資料結構架構(Schema),模型便能根據對話上下文,自主生成結構化的 JSON 參數:
{
  "tool_call": "update_crm_deal_stage",
  "parameters": {
    "account_id": "ACC-94821",
    "target_stage": "Technical_Evaluation",
    "probability": 0.75,
    "audit_reason": "經由技術評估確認已完成跨多雲架構驗證"
  }
}
這項轉變對架構設計帶來了兩項關鍵要求:
- 確定性與 結構化輸出(Structured Outputs) 保證:在生產環境中,後端 API 無法容忍隨機格式或欄位缺漏。各大雲端平台現在均支援結構化輸出,透過語法限制(Grammar Constraints)在 Token 解碼階段強制模型生成符合 JSON Schema 的輸出,杜絕解析失敗。
- 權限最小化與執行沙盒:Agent 擁有了調用外部工具的權力,意謂著傳統軟體工程中的權限控制邊界必須重新劃定。AWS Bedrock Agents 透過綁定 IAM Role 嚴格限制 Action Group 能碰觸的 Lambda 函數與 S3 存取範圍;Azure 則利用受控識別(Managed Identity)確保 Agent 存取內部 SQL 或 Dynamics 365 時具備最小權限,避免提示詞注入攻擊(Prompt Injection)導致未授權的資料竄改。
架構轉變三:從無狀態對話,走向長期記憶與企業級護欄評測
早期的 Chatbot 多數是無狀態(Stateless)設計,每次連線僅依賴有限長度的 Context Window 保存短暫對話。但對於需要長期協作的企業級 Agent,記憶體系統必須被劃分為短期的工作記憶與長期的情境記憶。
現代雲端架構的第三個轉變,是將狀態管理與企業合規防護深度整合進平台中。在企業實際落地過程中,技術主管最常擔憂的並非模型推論不夠聰明,而是模型失控、輸出幻覺或洩漏商業機密。
為了解決這個痛點,三大雲端平台在 2025 年後皆推出了獨立於模型本體之外的 企業級護欄(Guardrails) 架構:
- 輸入層檢驗(Input Filtering):在使用者輸入抵達模型之前,護欄系統即時掃描並攔截潛在的提示詞注入、越獄指令(Jailbreak)以及敏感個人資料(PII)。
- 輸出層查核(Output Grounding):比對模型生成的內容與檢索出來的一手文獻,計算「真實性指標」(Grounding Score)。如果生成內容包含文獻未記載的數字或承諾,護欄可自動改寫或阻斷輸出。
- 敏感資訊去識別化(Data Redaction):自動識別信用卡號、身分證字號與內部系統密鑰,並在模型處理前後進行遮蔽,符合嚴格的資安法規要求。
例如 AWS Bedrock Guardrails 允許團隊在不修改一行應用程式代碼的情況下,統一設定阻擋話題、自訂有害詞彙庫與遮蔽規則;Azure AI Content Safety 則提供多模態內容審查與防詐欺檢測,為科技團隊提供了獨立於模型版本升級之外的防護底線。
科技團隊在多雲與自建 Agent 之間的選型考量
面臨雲端三巨頭的激烈競逐,科技團隊在技術選型時不應盲目綁定單一供應商,而應根據業務特性評估關鍵維度:
1. 企業資料駐留與網路邊界
如果企業的核心資產儲存在既有地端資料庫或專用雲端 VPC 內,Agent 架構必須具備私網連線能力。例如微軟 Azure 憑藉與 Active Directory、Microsoft 365 生態圈的緊密整合,在企業內勤自動化場景佔據優勢;而 AWS 則以極為細緻的 IAM 權限體系與 VPC 終端節點(Endpoints),適合對資安隔離有極致要求的金融與科技製造業。
2. 多代理協作架構 的複雜度
複雜任務往往無法由單一 Agent 獨力承擔,而是需要多個專職 Agent 協同作戰。例如由「資料檢索 Agent」負責撈取數據,「分析 Agent」負責交叉比對,最後交由「審核 Agent」進行合規檢查。Google Cloud Vertex AI 在多模態處理與長文本關聯分析具備強項,而開源生態圈中的 LangGraph、Semantic Kernel 則提供了避免被特定雲端平台綁定(Vendor Lock-in)的抽象層。
3. 企業私有數據中台的整合介面
Agent 的智慧完全取決於它能讀取到的資料品質與廣度。單靠文件向量化無法支撐真實業務決策,Agent 必須能夠無縫對接具備業務語義的數據中台。
在實務架構中,許多企業選擇將內部知識庫與對話流程交由專業平台管理。例如愛酷智能科技(AccuHit)的生成式 AI 對話平台 AccuFlow.ai,能夠部署在企業專屬的 Azure OpenAI 或私有雲架構之上,讓技術團隊在幾行配置內串聯內部行政、行銷與產品規格知識庫;同時搭配顧客數據平台 AccuCDP,將全通路的會員行為與交易訊號清洗為標準化 API,提供給企業各類 Agent 作為決策依據。
科技團隊現在可以立刻開始的 3 件事
要將系統架構從傳統 API 驅動逐步演進為 Agent 驅動,科技團隊不必一步到位重構整套核心系統,建議從以下三個步驟著手:
- 盤點內部高頻且規則明確的跨系統工作流:挑選目前依賴人工在兩到三個後端系統間切換搬移資料的場景(例如客訴案件分流、帳單對帳異常通報),作為第一個 Agent 原型概念驗證(PoC)。
- 將內部現有 API 進行 OpenAPI(Swagger)標準化:確保後端微服務的參數說明、型態定義與錯誤代碼具備清晰的文字描述。優質的 API 說明文件是模型正確理解並精準調用工具的基石。
- 建立企業級 評測與監控基準(Evaluation Harness):在 Agent 上線前,準備至少 50 組涵蓋極端邊界條件(Edge Cases)的測試集,監控每次模型規劃的路徑準確度、工具調用成功率與 Token 成本,建立持續整合與驗證體系。
雲端三巨頭的 AI Agent 競賽正在加速基礎設施的成熟。對於科技團隊而言,理解這三大架構轉變並及早佈局系統整合介面,將是讓技術資產在生成式 AI 浪潮中轉化為實質競爭力的關鍵節點。
延伸閱讀
- 上雲不等於轉型:愛酷智能談 Cloud、Data 與 MarTech 的三層整合
- Claude Duet 與 Claude Code 差在哪?背景代理、本機執行與企業選型 4 大關鍵
- AccuFlow.ai 企業知識庫|打造一問即答的企業智慧核心
想進一步了解如何將生成式 AI Agent 與企業內部私有知識庫、顧客數據平台深度整合?歡迎聯繫愛酷智能科技顧問團隊。
常見問題
AI Agent 與傳統 RAG 架構最大的差別是什麼?
傳統 RAG 是單向的線性檢索管線(檢索文件後填入提示詞由模型回答),缺乏推理反思與外部系統操作能力。AI Agent 則具備「目標拆解、觀察反思、動態終止」的自主推理循環(如 ReAct),並能透過 OpenAPI 標準調用外部 API 執行具體任務(如查詢庫存、觸發 CRM 流程),從被動問答升級為主動解決問題。
企業導入 AI Agent 該自建框架還是使用微軟、AWS、Google 雲端託管?
建議依團隊成熟度與現有雲端基礎設施分層選型。若核心業務已在特定公有雲上,優先採用該雲原生的託管環境(如 Azure AI Foundry、Amazon Bedrock Agents 或 Vertex AI Agent Builder),可直接享有雲端等級的 IAM 權限控管、企業護欄與無伺服器計算;若需要高度客製化的多代理協作邏輯,則可在託管容器中運行 LangGraph、Semantic Kernel 或 AutoGen 等開源框架。
導入 AI Agent 時,如何確保企業內部資料安全與合規?
主要透過三道防線:第一,網路與儲存隔離,利用 Private Link 與 VPC Service Controls 確保資料傳輸不走公開網路;第二,身分與權限控管,為 Agent 指派最小權限原則的 IAM Role,嚴格限制可讀寫的資料庫與 API 範圍;第三,即時護欄與審計日誌,透過 Azure AI Content Safety 或 Bedrock Guardrails 阻擋提示詞注入攻擊(Prompt Injection),並全程記錄工具調用日誌供後續稽核。
關於 AccuFlow.ai 與 AccuCDP
AccuFlow.ai|企業級 AI Agent 平台。 以無程式碼(No-Code)設計協助企業快速建立專屬的 AI 智慧助手、企業知識庫與受控自動化工作流。核心功能包含企業知識庫與 RAG 檢索、L2 受控代理工作流、多層規則與合規檢查,以及 Web 與 LINE 官方帳號全通路客服與人機協作。適合希望將生成式 AI 落地為標準流程的中大型企業。
AccuCDP|跨渠道顧客數據平台。 整合品牌所有渠道的破碎數據,透過 AccuID 技術建立單一顧客輪廓,為企業各類 AI Agent 提供清洗後的標準化行為資料與受眾分群標籤。
了解更多可至愛酷智能科技官網。
資料來源
- Microsoft Learn,〈Azure AI Foundry documentation〉與〈Semantic Kernel Overview〉(微軟官方架構文件,涵蓋 Azure AI Content Safety 與 Private Link 技術規格)。
- Amazon Web Services Documentation,〈What is Amazon Bedrock Agents?〉與〈Amazon Bedrock Guardrails〉(AWS 官方文件,涵蓋 Action Groups 與 IAM 角色隔離架構)。
- Google Cloud Documentation,〈Vertex AI Agent Builder Overview〉與〈Reasoning Engine〉(Google Cloud 官方文件,涵蓋 Python 類別封裝與 Model Armor 安全機制)。