某家台灣中型電商的行銷主管,一月底在月度報告上發現一件讓她倒抽一口氣的事。LINE OA 開封率從十二月的平均 27% 跌到一月的 13%,但問題從一月初就開始了。
她的團隊每週一會打開行銷後台確認廣告花費有沒有失控。問題是,沒有人設定要追蹤開封率的逐日趨勢。數字在三週內慢慢滑落,沒有任何工具告訴她「有問題」。等月報裡的圖表出來,一月份的 LINE 推播預算已經用了八成,全花在一個效果打了折的渠道上。
這不是個人疏失。是整個監測機制的設計,讓問題只能在月報時被發現。
為什麼行銷問題通常等月報才被發現
傳統月報的流程設計決定了問題至少要過三到四週才能被看見,這不是因為沒有人在看,而是「盯報表」本來就是一種落後的監測方式。
月報週期本身就是延遲的來源。 如果行銷活動是一號開始的,月報在三十一號才出,問題在十五號發生,你要等兩週後才發現。這期間所有的預算繼續燒,所有的受眾繼續收到效果不佳的訊息。更麻煩的是,很多問題不是單日急跌,而是逐漸漂移——開封率從 27% 慢慢走到 20%、18%、15%,每一天的下降都不顯眼,加總起來卻已經嚴重偏離正軌。
人工盯盤的覆蓋率天生不完整。 管理 50 個以上廣告活動、橫跨三個以上渠道的行銷作業人員,每週平均要花 8–15 小時在手動查看儀表板上(來源:Improvado《Marketing Anomaly Detection & Alerts Guide》,2026)。這個時間本身就已經很多,但即使如此,能穩定每日追蹤所有指標的,不是多數人的現實。人會優先看最熟悉的指標、最近的活動、最在意的平台——其他的就很容易漏掉。
報表是針對預期問題設計的,不是針對未知問題。 你在報表上放了什麼欄位,才能看到什麼資料。如果你沒想到「LINE OA 帳號品質評分」這個指標,就算它正在下滑影響觸達,你也不會知道——因為報表根本沒這一欄。
這就是為什麼未建立自動化監測機制的行銷團隊,每月廣告預算中平均有 15–25% 花在「幾個小時內就能截獲的問題」上(Improvado,2026)。那些錢不是沒效果,是花在已經出問題的渠道或受眾上,而問題可以更早知道。
延伸閱讀:KPI目標制定全攻略!簡單「五步驟」教你打造高效追蹤系統
AI 行銷預警系統是什麼?跟儀表板的本質差異
AI 預警系統的核心不是讓你看更多數字,而是讓系統在數字超出正常範圍時主動告訴你。這是一個方向上的根本翻轉。
傳統儀表板和 BI 工具的設計邏輯是「你去找問題」:你需要主動登入後台、選擇時間範圍、決定要看哪張報表、再自己判斷有沒有異常。整個流程的主語是「你」,系統只是一個資料展示介面。
AI 預警系統反過來。系統持續地在後台監測你設定的指標,當某個數值偏離正常基準時,系統主動推送通知——你不需要去找,問題找到你。整個流程的主語是「系統」,你只需要在收到通知後決定要怎麼處理。
這個差異看起來簡單,但影響很大。它的意義不只是省時間,而是把偵測行為從人類記憶力和工作排程中解放出來——系統永遠不會忘記盯那個你三週沒打開的渠道報告。
靜態閾值 vs. 動態基準:技術層面的關鍵區別
早期的預警系統大多是「靜態閾值」邏輯:設定「如果開封率低於 20% 就通知我」,系統就按這個條件觸發。這個方法簡單,但問題在於,20% 對某些帳號可能是正常值,對另一個帳號可能是優異表現。固定數字沒有個人脈絡。
AI 驅動的預警系統走的是「動態基準」邏輯:系統學習你帳號的歷史表現,建立你自己的「正常範圍」,並在實際數字顯著偏離這個範圍時才觸發。這樣的偵測能考慮週間效應(週一開封率本來就比週末低)、做到季節性修正(雙十一前後的 ROAS 基準不同)、也能感知漸進趨勢而不只是單日急跌。
ML 異常偵測通常需要至少 4–8 週的歷史數據來建立穩定的季節性基準,以避免假警報(Improvado,2026)。這個建置成本是真實的,但一旦基準建好,後續的偵測精度比靜態閾值高得多。
Salesforce 在第九版《State of Marketing》報告(2024)指出,高績效行銷團隊採用 AI 的可能性是低績效團隊的 2.5 倍;同一份報告也顯示,僅有 31% 的行銷人員對整合顧客數據的能力感到完全滿意。這兩個數字放在一起有個意思:多數行銷團隊知道 AI 重要,但資料整合還是一個尚未解決的前提條件——而它正是預警系統能不能好好運作的基礎。
延伸閱讀:行銷自動化進入 AI 代理人時代:2026 下半年趨勢與品牌應對指南
建置前先想清楚:哪些 KPI 值得被監測
並不是所有 KPI 都應該接進預警系統——這一點反而常被忽略,結果是系統設了太多告警,行銷人員每天收到二十幾封通知,最後開始習慣性略過,預警系統形同虛設。
有效的預警系統只監測三類指標:
第一類:有基準線可比較的指標。 這個指標需要有足夠的歷史數據能定義出「正常範圍」。如果一個新開的渠道只跑了兩週,還沒有足夠的歷史基準,預警系統對它的判斷就不準——先讓它跑夠久,再加進監測。
第二類:下滑後能在 24–72 小時內採取行動的指標。 有些 KPI 你看到了也沒辦法立刻做什麼(例如品牌知名度這類長週期指標),那接進每日預警只會製造焦慮。預警系統最有價值的,是那些「發現了立刻可以調整」的操作性指標,像是廣告出價、推播分眾、旅程觸發條件。
第三類:偏離後會直接影響業務的指標。 如果某個指標異常了,但就算不管它也不會發生什麼事,那它就不需要預警。預警系統是稀缺注意力的分配工具——它的稀缺性決定了它的價值。
依這個框架,行銷預警系統通常會監測三層 KPI:
- 渠道健康層(每日監測):LINE 開封率、Email 開信率、廣告 CTR、社群觸及率
- 效益轉換層(每日–每週監測):廣告 ROAS、轉換率、每次獲客成本(CAC)、購物車棄單率
- 業務影響層(每週–每月監測):收益下滑趨勢、高風險流失會員佔比、新客復購率
越接近業務影響層的指標,監測週期通常越長,但一旦異常,嚴重性也越高。這三層指標之間有因果關係——渠道健康下滑(開封率)會在幾天後反映到效益轉換(ROAS),再過幾週影響業務層(收益)。預警系統的最大價值,是讓你在渠道健康層就截獲問題,不用等到業務層才發現。
建置 AI 預警系統的 4 個核心設計關鍵
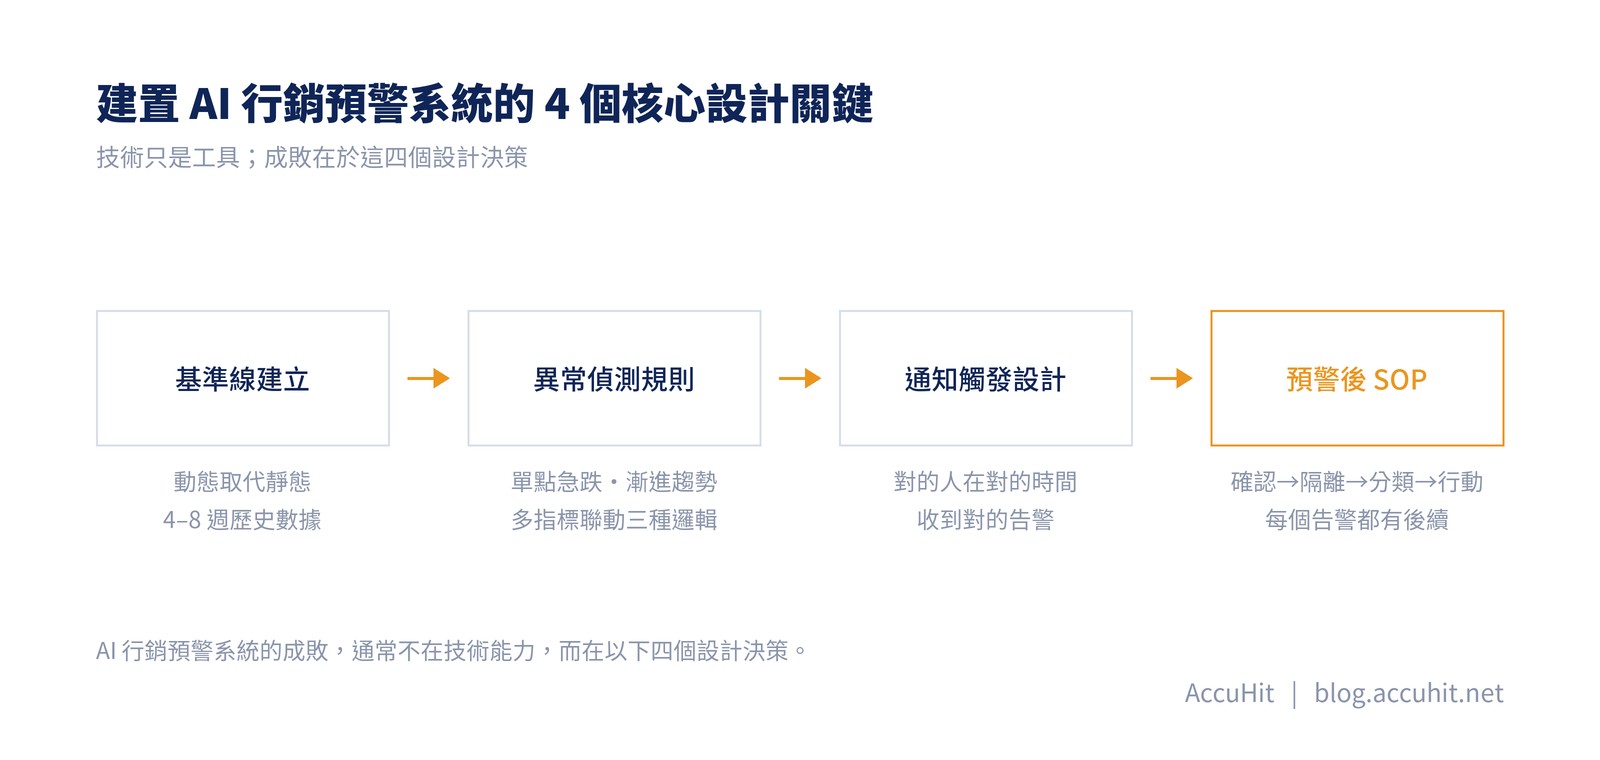
AI 行銷預警系統的成敗,通常不在技術能力,而在以下四個設計決策。技術只是工具;決定系統好不好用的,是在工具上疊的那一層邏輯。
設計關鍵一:基準線的建立——動態比靜態更準
基準線是整個預警系統的核心。「什麼叫正常」沒定義清楚,就無法判斷什麼叫異常。
靜態閾值(如「開封率低於 20% 就告警」)的問題在於它完全忽略脈絡。對某些行業、某些渠道、某些受眾組合,20% 是好成績;對另一些,27% 才是平均水準。用同一個絕對值監測所有情況,假警報和漏警報都會很多。
動態基準的建法有幾種常見選擇:
- 滾動平均法:用過去 7 天或 14 天的平均值作為今天的基準,比較今天的值相對基準偏移了多少百分比
- 加權滾動平均:對近期的數據給更高的權重——這讓基準能跟著趨勢更新,不會被三週前的異常值拉偏
- 季節性基準:對有明顯週期性的 KPI(如電商雙十一前後的 ROAS),使用去年同期的相對基準,避免旺季的數字把淡季的基準整個拉高
ML 偵測模型一般需要 4–8 週的歷史數據才能建立穩定的季節性基準(Improvado,2026)。如果你的帳號或渠道比較新,先用簡單的滾動 14 天平均出發,等有足夠數據後再升級到更精細的模型。
設計關鍵二:異常偵測規則——不是一個數字,是一套組合邏輯
判斷「有沒有異常」不能只靠單一數字,需要一套偵測邏輯的組合。三種基本異常類型,各有對應偵測方式:
單點急跌:今天的值 vs. 過去 7 天平均,偏移超過某個百分比(例如 -20%)就觸發。這適合偵測突發性問題,像是投放腳本出錯、推播被平台降權、廣告素材被限流。這類問題通常需要當日處理。
漸進趨勢下滑:不看單日,而是計算過去 5–7 天的每日平均變化方向,連續負值超過 3 天就觸發。這適合偵測慢燃型問題,像是受眾疲乏(同一群人被推播太多次)、競品入場造成的廣告競爭加劇,或是訊息相關性逐漸下降。
多指標聯動異常:當兩個或更多個相關指標同時偏離基準才觸發。例如「開封率下滑」加上「推播量正常」,代表受眾真的在忽略你的訊息;反之如果只有開封率下滑但推播好友總數同步下滑,問題可能是名單在縮小。多指標聯動可以大幅減少假警報,讓每次告警都更值得認真對待。
設計關鍵三:通知觸發時機與告警格式——讓對的人在對的時候收到
告警的分層設計,決定了你的團隊會不會認真對待每一個通知。實務上,行銷預警系統建議分三個層次:
即時告警(1–2 小時內):廣告支出速率異常(日預算已用 70% 但才中午)、轉換率單日崩跌超過 30%。這類問題拖一天可能就是幾萬元的損失,需要在工作日內立刻處理。
每日摘要推播(每天早上 9 點):前一天各渠道 KPI 偏移彙整,超過偵測閾值的項目逐條列出。建議格式三行:哪個指標、偏移了多少、跟基準比差在哪。行銷人員看完五分鐘就能決定要不要立刻跟進。
每週趨勢報告(每週一早上):過去七天的趨勢線異動,包括緩慢下滑但尚未觸發即時告警的指標。這一層是給管理層的,不需要立刻處理,但要知道這週需要多關注哪些地方。
告警內容格式也很關鍵。一個好的告警通知應該包含:哪個 KPI 出現異常(例:LINE OA 開封率)、當前值和基準值是多少、偏移量和持續天數、一行可能原因提示(由系統根據歷史模式預填)、以及一個直連後台的連結——讓收到通知的人不需要花時間找在哪裡,直接去確認就好。
關於告警疲勞問題:如果每天的通知太多太碎,行銷人員會開始習慣性略過,這是預警系統最容易失敗的地方。Improvado 的基準數據顯示,一個健康運作的預警系統,告警確認率應該維持在 70–85%。如果低於 50%,通常意味著系統靈敏度太高,需要調整觸發條件,而不是靠人力的意志力去追。
設計關鍵四:預警後的標準處理流程——讓每個告警都有後續
收到告警之後要怎麼辦,這是最多人忽略的一步,也最常讓整個預警機制功虧一簣。
常見的失敗場景:系統發了告警,行銷人員看到了,打開後台翻了幾分鐘,不確定問題在哪,就繼續去做別的事——因為沒有一套標準的排查邏輯,面對異常時很容易不知道從何查起。
每種告警類型都應該有對應的排查 SOP:
第一步:確認數據可靠性。異常是真實的業務問題,還是追蹤工具本身的問題?常見的追蹤碼失效、GA4 過濾器設定錯誤、UTM 遺漏都可能讓報告數字失真。
第二步:隔離問題範圍。是所有受眾都受影響,還是某個特定分群?是所有渠道都有這個現象,還是只有某個平台?縮小範圍,才能找到根因。
第三步:分類問題性質。數據問題(追蹤失靈)?戰術問題(素材疲乏、出價被競爭)?結構問題(受眾定義需要重設、旅程節點失效)?
第四步:行動或升級。如果是你能處理的戰術問題,直接調整;如果是結構問題,標記為需要下次迭代;如果超過你的授權範圍,向上升級。每次告警的排查結果都記下來——幾個月後你會發現,有幾類告警幾乎都是假警報(可以調高閾值),有幾類告警幾乎都是同一個根因(可以直接寫進 SOP)。
三個行銷場景的實際偵測邏輯
以下三個場景說明預警系統怎麼在不同 KPI 類型下運作,以及各場景的偵測邏輯有哪些差異。
場景一:LINE OA 開封率異常下滑
建議用 7 天滾動平均作為基準,觀察期為連續 3 天。觸發條件:7 天基準值相對 28 天基準值下滑 20% 以上,且排除「發送頻率明顯增加」的干擾(過量推播本身會稀釋開封率,那是設計問題不是異常)。
收到告警後,排查順序依次是:發送頻率(過去兩週是否推播次數明顯增加)→ 訊息類型(特定類型的推播開封率是否特別低)→ 受眾疲乏(已靜音或長期未互動的好友佔比是否上升)→ LINE 帳號品質評分(高頻低相關的推播會讓 LINE 平台對 OA 的內部評分下降,影響觸達效果)。
LINE OA 的開封率計算是「訊息被點擊開啟」而非「預覽」,數字本來就偏低於 Email。基準線要用同帳號的歷史數據,不能跨平台比較。
場景二:廣告 ROAS 持續偏離基準
廣告 ROAS 天生有波動性,週末跟週間、節慶前後都可能差很多,所以不適合用單日數字作偵測依據。建議以 14 天滾動 ROAS 作為基準,連續 2 天 ROAS 偏低超過 15% 才觸發——這樣可以過濾單日波動,保留真實趨勢信號。
Improvado 的案例數據說明了為什麼早期偵測重要:CPA 在第 3 天被偵測到偏移 20% 的上升,可以比第 14 天才發現(此時 CPA 可能已上升 60%)省下 8–11 天的無效支出(Improvado,2026)。
告警觸發後排查順序:廣告素材 CTR(素材疲勞是最常見原因)→ 受眾重疊率(是否已飽和,開始競爭同一群人)→ 競品投放強度變化(可用 Facebook Ad Library 查)→ 落地頁轉換率(廣告端沒問題,但落地頁可能有斷點)。
場景三:會員流失的早期信號偵測
這個場景屬於預測性告警,不是偵測「某個數字下滑了」,而是偵測「某個群體開始出現流失前的行為模式」。
偵測邏輯:以「過去 30 天無購買行為」的高價值會員佔比作為追蹤指標,計算每週的週增速率。如果前三個月有兩次以上購買的會員中,「進入 30 天靜止」的比例較前四週平均上升 10% 以上,觸發告警。
這個告警的意義不是「已經流失了」,而是「正在走向流失的早期信號出現了」。在這個窗口期介入(發個有脈絡的個人化再購旅程訊息),挽回率遠高於等到六十天靜止才行動。
常見問題
AI 行銷預警系統跟一般 BI 工具差在哪?
BI 工具的設計邏輯是「你主動查報告」;預警系統的設計邏輯是「系統發現偏差後主動通知你」。兩者都需要數據,但 BI 需要你知道要去查什麼,預警系統負責找你還不知道要問的問題。實際上很多企業兩者都需要——BI 用來做深入分析,預警系統用來確保沒有東西在你不注意時悄悄出問題。
要先有多少歷史數據,AI 才能建立準確的基準?
一般需要至少 4–8 週的歷史數據才能建立初始基準,有季節性規律的 KPI(如電商大促前後、餐飲旺淡季)建議有跨年度數據才能避免誤判。剛起步的做法是先用簡單的 14 天滾動平均作為基準,等數據夠多後再引入季節性修正。
預警系統需要工程師才能建置嗎?
基礎的動態閾值告警,許多 CDP 和行銷自動化平台已有內建,行銷人員可以自行設定條件和通知渠道。進階的 ML 異常偵測(考慮季節性、多指標聯動)則通常需要數據工程支援。建議從平台內建功能出發,先把流程跑通,再視需求升級偵測精度。
收到預警之後,接下來應該怎麼處理?
第一步永遠是確認數據來源可靠(排除追蹤工具失效)。確認數據真實後,隔離問題範圍(哪個渠道、哪個受眾),分類問題性質(數據問題 / 戰術問題 / 結構問題),再決定要立刻行動還是排入下週的優化計劃。每次處理完記得歸檔——這些記錄會慢慢變成你的 SOP 資料庫。
現在可以立刻開始的 3 件事
- 列出你最重要的 5 個行銷 KPI,為每一個手動計算過去 4 週的平均值。 這就是你的基準線起點,也是判斷「什麼叫正常」的第一步,不需要任何工具,一張試算表就夠。
- 為你的廣告渠道設定一個基礎的預算超支告警。 Google Ads、Meta Ads Manager 都有內建的支出上限通知,五分鐘可以設好,這是零成本的最基礎預警。
- 下次收到業績報告時,不只看數字,也問:這個數字是什麼時候開始偏的? 問這個問題會讓你開始意識到偵測延遲在哪裡,這是建立預警意識最實際的起點。
如果你的行銷數據分散在 LINE OA、官網、廣告平台、CRM 等多個系統,而你希望把這些數據整合進統一的監測架構,AccuCDP(愛酷的跨渠道顧客數據平台,介紹見文末)的洞察分析模組具備異常示警功能,能把分散的渠道信號匯進同一個監測層。
關於 AccuCDP
AccuCDP 是愛酷智能科技推出的跨渠道顧客數據平台,一句話定位是:整合品牌所有渠道的破碎數據,透過 AccuID 技術建立單一真實顧客輪廓,讓數據從「有」變成「能用」。
在行銷 KPI 預警的應用上,AccuCDP 的洞察分析模組具備異常示警功能,能夠追蹤跨渠道的行為數據,並在指定條件下主動通知。主要功能包含:
- 跨渠道數據整合:整合 LINE、官網(FPC 埋碼)、CRM、POS 等數據進單一平台
- AccuID 技術:記錄匿名訪客並串連實名身份,讓行為數據不因渠道切換而斷線
- 洞察分析模組:行為量化、行為探索水流圖、行動時間軸(找流程卡點)、異常示警
- 多維度標籤體系:觸發型、CRM 屬性型、自定義型標籤,支援跨渠道分群監測
- ISO 27001 & ISO 27701 認證:數據安全符合國際標準
適用情境:數據分散在多個平台、需要統一基準線監測跨渠道 KPI、想在問題影響業務之前就被主動通知。
想了解更多或預約 Demo,歡迎至 accuhit.net 或直接聯絡 [email protected]。
資料來源
- Improvado,《Marketing Anomaly Detection & Alerts Guide》, 2026
- Salesforce,《State of Marketing》第九版, 2024